最强AI画《蒙娜丽莎》
文章目录
01. AI画画「小学生水平」
之前一直都在讲干货,今天轻松点介绍一个有意思的开源仓库:https://github.com/hershalb/canvas-arena
仓库作者想让AI通过画笔,临摹《蒙娜丽莎》和《星夜》,测试下目前AI的临摹水平。
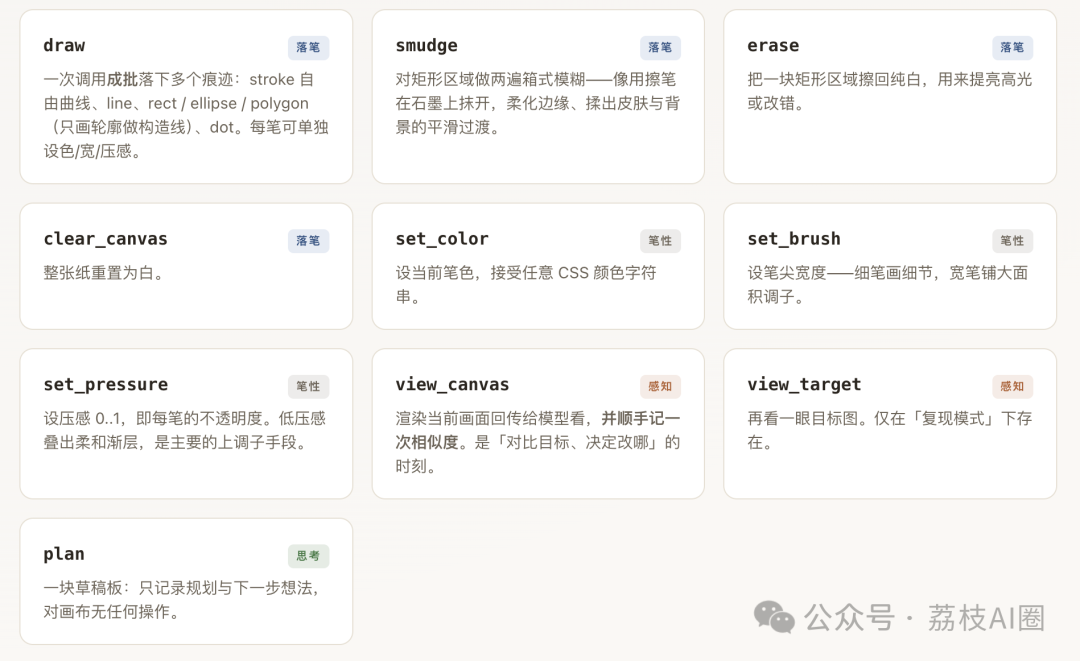
作者给目前公认的最强模型 GPT-5.6 Sol、Claude Fable 5、Grok 4.5、Gemini 3.6 Flash,每人一张白纸和一套工具,工具包含:调色、换笔尖、调压力、画线、涂抹、擦除,看画布和原画。
下面是代码里给到LLM对应的画画工具:
下面是最终结果:
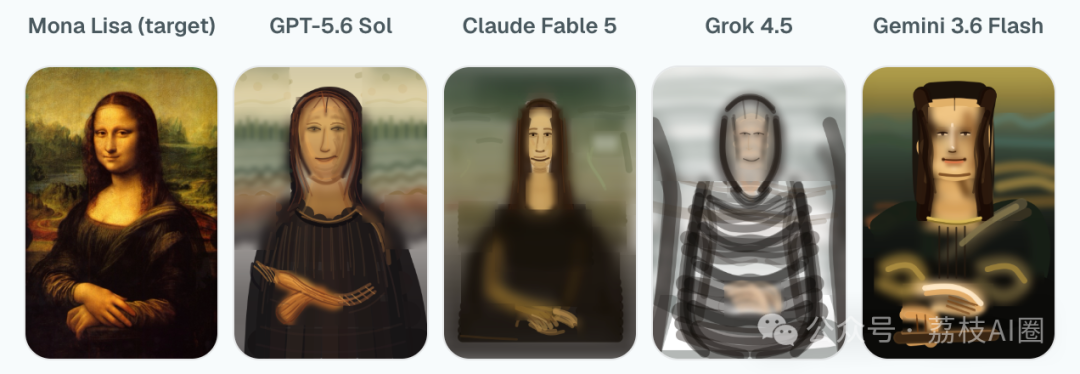
最终结果:GPT-5.6综合表现最好,细节最强,《星夜》全场最佳,Claude排第二,但是最贵,耗费是其他模型的将近20倍。Gemini中规中矩,Grok主要负责搞笑的。
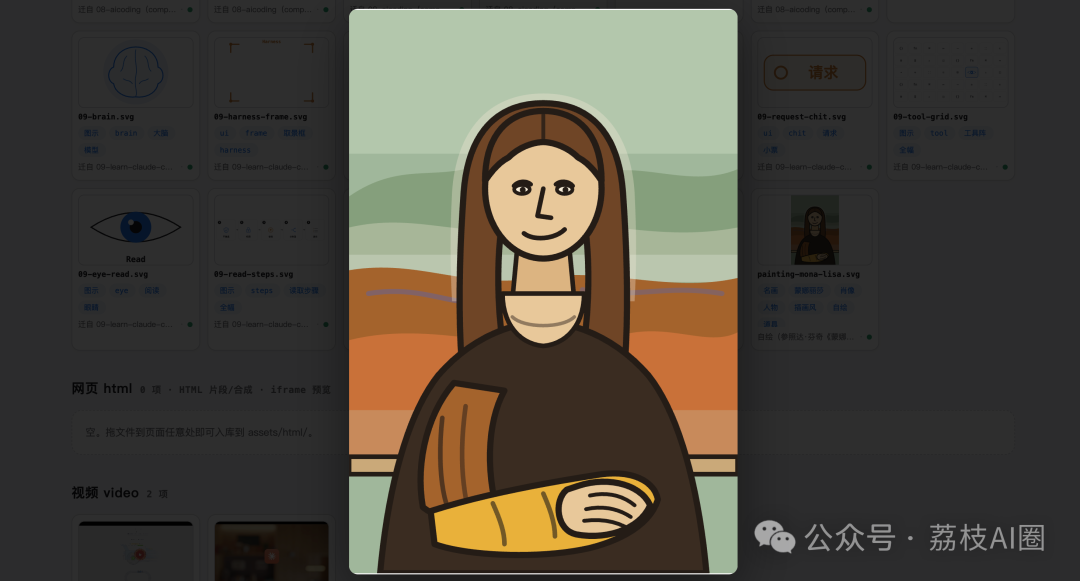
我最近也在搭建一套动画harness,也顺便尝试画了下,工具主要是各种几何图形,同样惨不忍睹,但我觉得略好于上面。
02. 拿笔画和生图的区别
可能有人会说,不对啊,ChatGPT 和 Gemini 不是画图很强的么,为什么画成这个鬼样子?
这里要解释下:你说的那是生图模型,而canvas-arena是一套画图的harness,让「AI」+「工具」按照原画进行临摹,看一眼画一画,流程更像人画画的过程。
下面简单解释下两者区别。
一、生图模型
生图模型考的是先验——它记住了几亿张画长什么样,生图的时候是进行像素的推算。
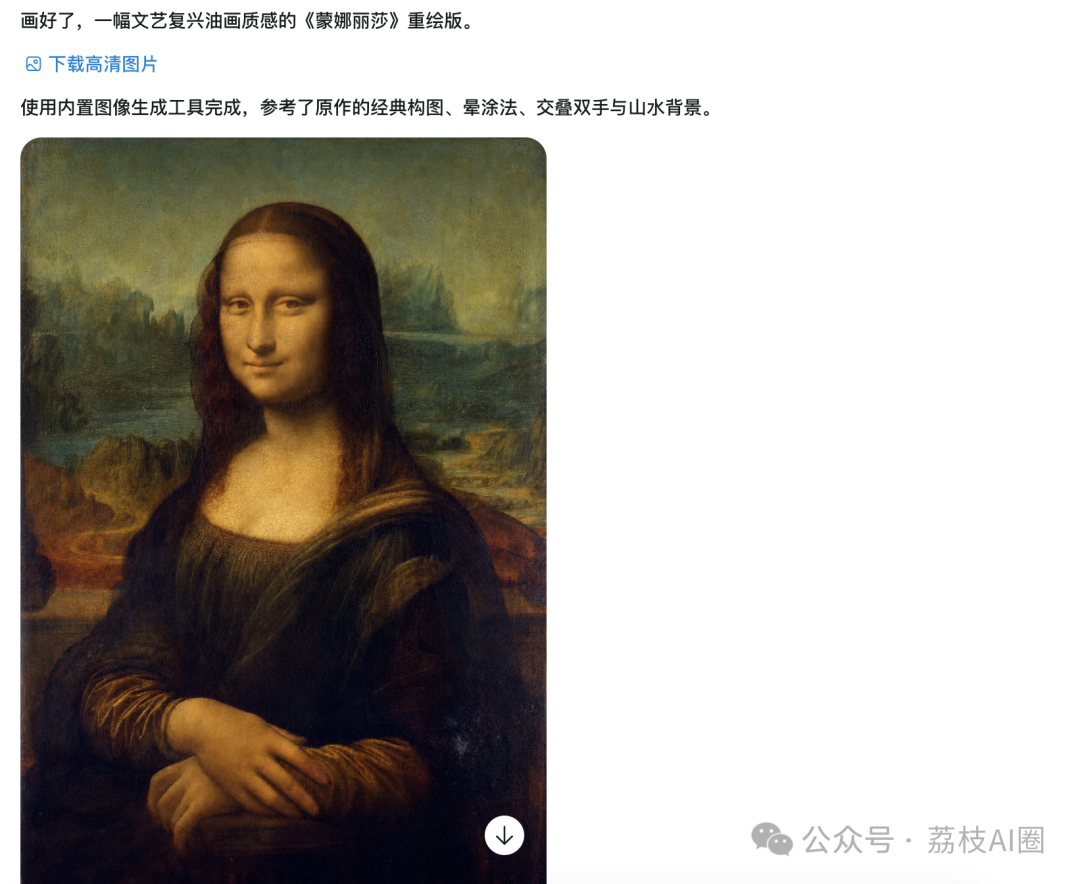
二、画图的harness「canvas-arena 」
这套harness测试考的是执行闭环——通过LLM大脑,看懂、规划、下手、回看、修正、停手。
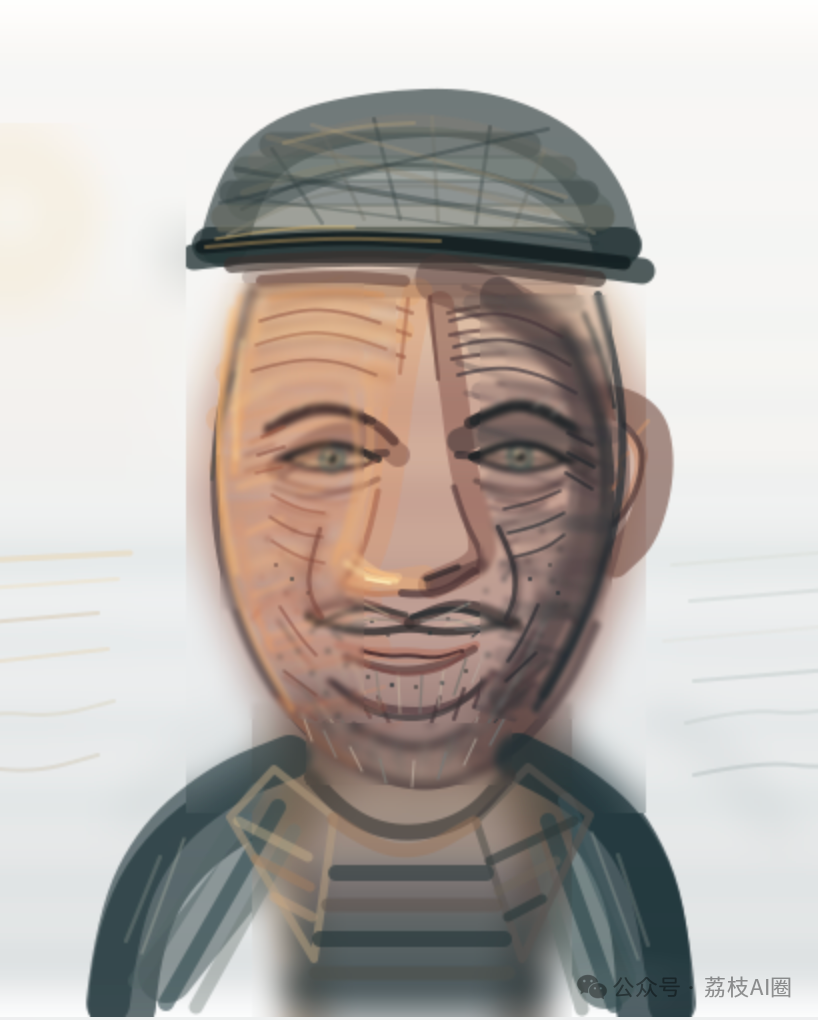
也正因如此,这套东西有个生图模型永远给不了的东西:过程可审计。每一笔为什么这么画、哪一步开始改坏,都能倒回去看。
而生图模型出图是一次性的黑箱,存在不可解释性。
03. 要让Harness知道,什么是好
既然harness可以回放步骤,那我们来细看下具体的步骤,看看为什么会画成这样呢?
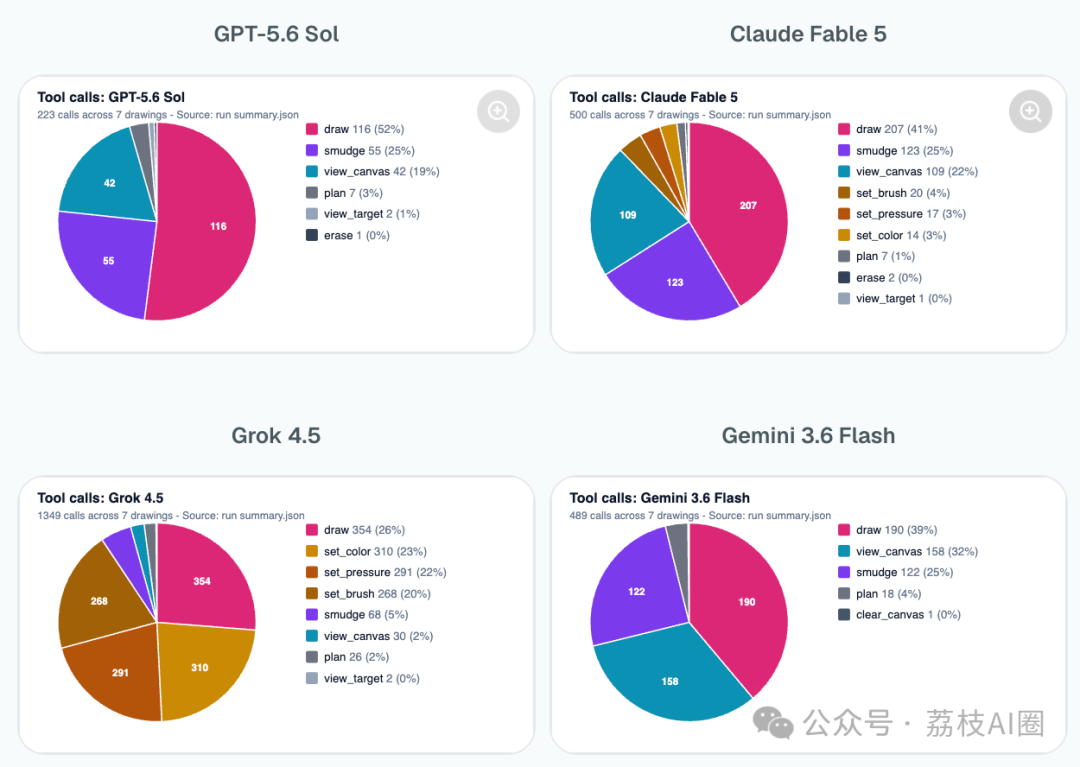
我们来看看各个工具的使用情况,其中Gemini 是全场最执着的自检者,平均每幅画会看23次,GPT-5.6 平均每幅画看6次。
而Grok几乎不看画,全程都在调色,换画笔,可以想象一个人在画室里忙了一小时,反复摆弄画具,纸上几乎没东西。
而且步骤记录中发现各个大模型画画的过程中都曾经画过更好,但是改来改去越改越不像。
所以最核心的问题,其实是不是AI不会改,是它好像不知道:什么时候已经够好了。
所以对于harness,如果没有好的评估标准,Harness很难优化出更好的结果。
04. 我也尝试搭建一个Harness
这也是Harness的魅力,通过工程化,给定标准,就可以进行调试和优化。
于是我就想,我如果给他各种形状,搭建一套Harness,它能画一些简单的动画么?
于是我给了AI画图工具,还有一些动画库,它真的画出来了简单的动画。
(我的办公空间)
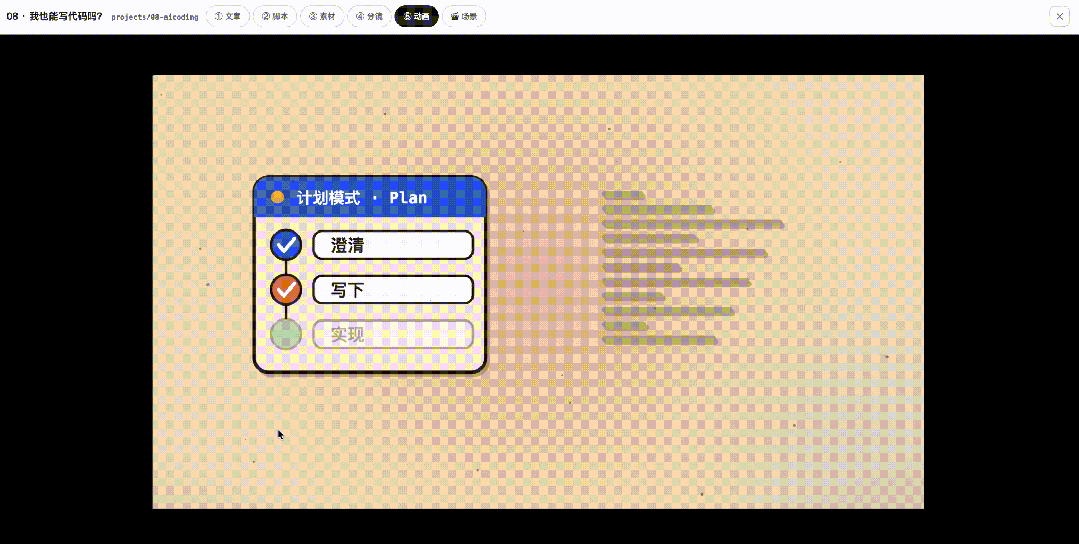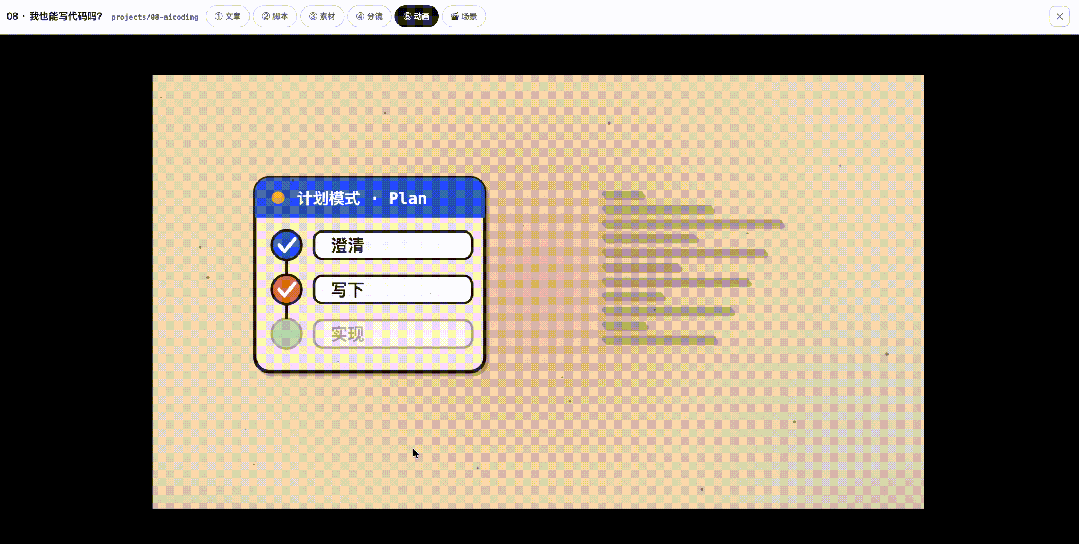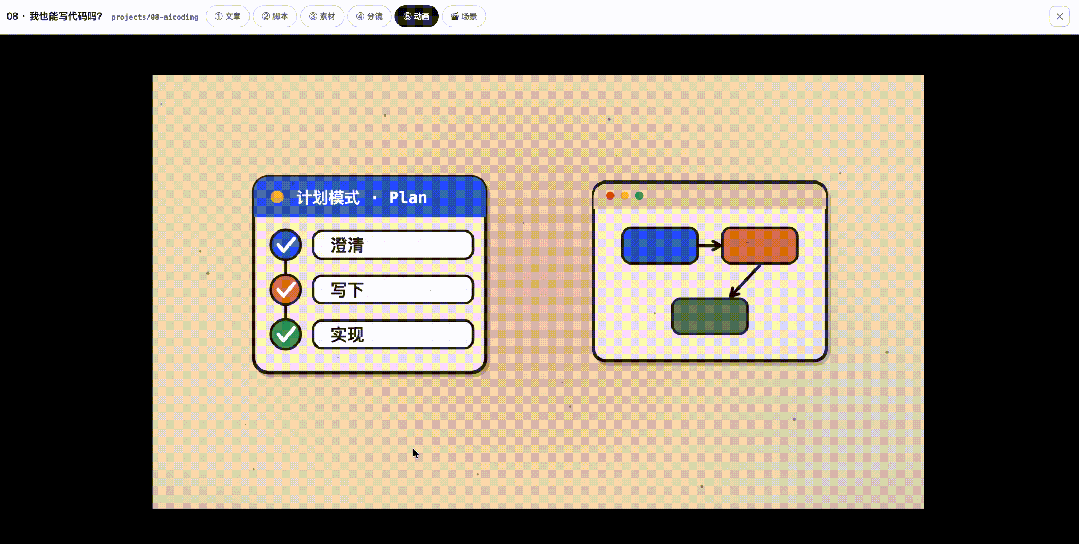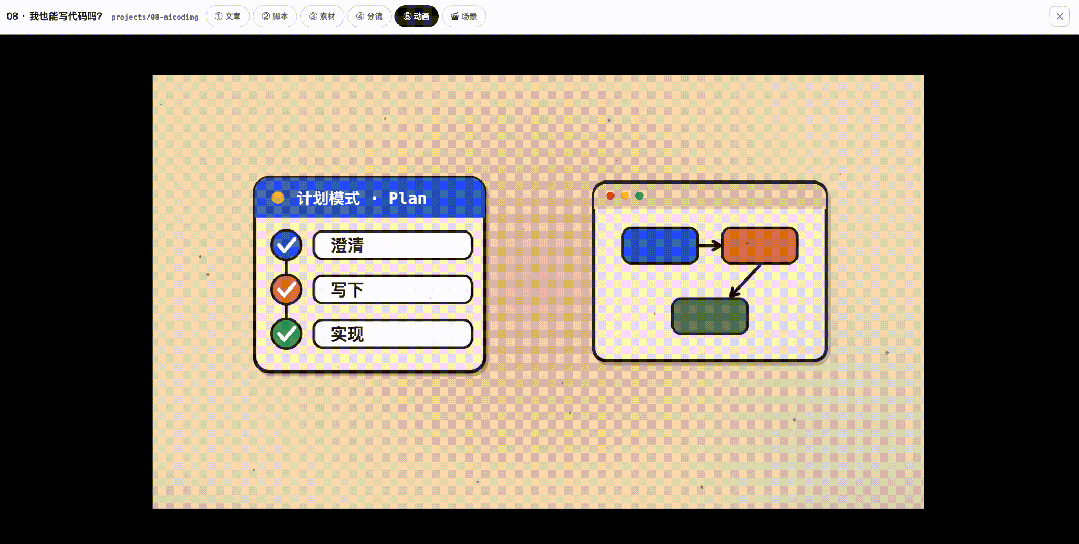
(上篇文章 有了AI,所有人都能写代码么? ,澄清部分的动画)
感觉搭建过程挺有意思的,像是在引导和教一个小孩儿做视频。
看文章是枯燥的,未来如果能转化成动画,看起来理解起来也会更轻松,目前harness还在搭建中,希望未来会用上。
05. 个人的思考
回过头来看,我觉得搭建一个Harness,最开始要思考的不是记忆如何做,上下文如何管理,多Agent如何协调。
最核心的是一个好的评测标准,一份足够丰富的,干净的,清晰的评估数据,得让harness先知道什么是好。
联想到最近看李飞飞的《我看见的世界》书里描述的ImageNet项目,也是为了搭建一套评估标准,人工标注了1500万张图片,想到这里肃然起敬。
也许一切的源头还得是数据。Harness是,LLM也是,他们本质是同一套东西。
作者提示: 个人观点,仅供参考