一张照片、一盘围棋、一个对话框:AI 是怎么突然开窍的?
文章目录
- 首尔棋盘上的「第 37 手」
- 一、第一堵墙:你能写出「认出一只猫」的所有规则吗?
- 1943 年《人工神经元》
- 1958 年《感知机(Perceptron)》
- 1986 年《Nature》经典论文《反向传播(Backpropagation)》
- 二、一张照片的逆袭:在算法爆发前,有人先花几年「编教材」
- 三、一盘围棋的两面:第 37 手看见突破,第 78 手看见边界
- 四、一个对话框的诞生:机器是怎么「听懂」人话的?
- 五、从「陪你聊天」到「替你干活」:补齐最后三块短板
- 1. 怕它乱编或不懂公司内部事?——让它「先翻书再回答」(RAG)
- 2. 怕它只会动嘴不会动手?——让它「边想边调工具」(ReAct)
- 3. 遇到难题总跳步算错?——让它「打草稿慢思考」(CoT → o1 → DeepSeek-R1)
- 写在最后:80 年 AI 史,其实是给普通人的「使用说明书」
- 参考资料与核心文献
程序明明是人写的,为什么它能走出一招连人类顶尖棋手都看不懂的棋?从 1950 到今天,机器进化的每一次破局,其实都在回答同一个问题——当规则写不完时,人类该怎么教机器认识世界。
首尔棋盘上的「第 37 手」
2016 年 3 月 10 日,韩国首尔四季酒店,全世界都在关注这场围棋战。
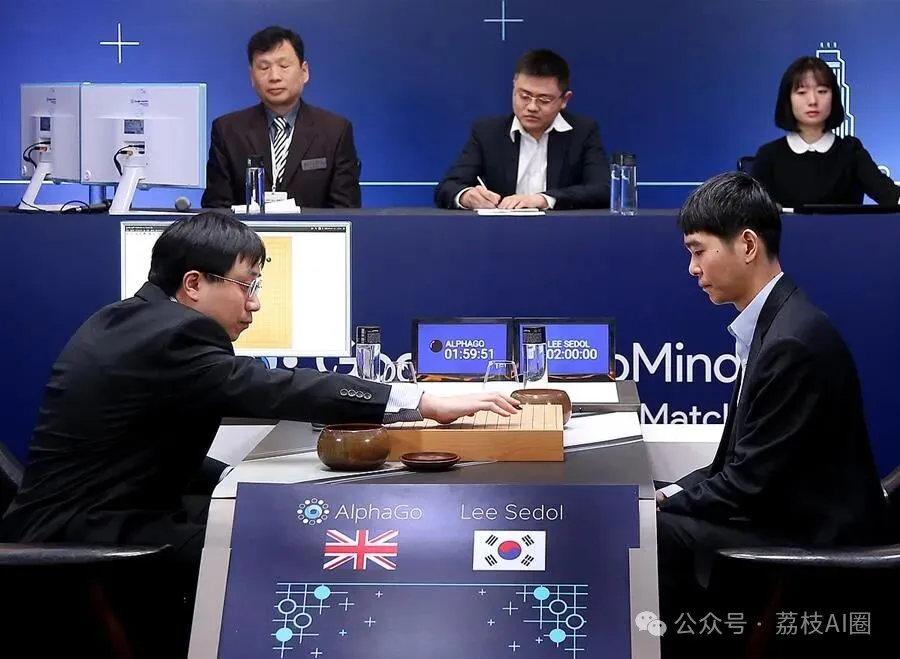
棋盘的一边,是手握 14 个世界冠军头衔的韩国传奇棋手李世石;另一边,是 DeepMind 团队开发的围棋程序 AlphaGo。
这是五局棋大战的第二局。下到第 37 手时,坐在屏幕前代为落子的黄士杰博士,把一颗黑子轻轻放在了棋盘右侧的「五路肩冲」位置。
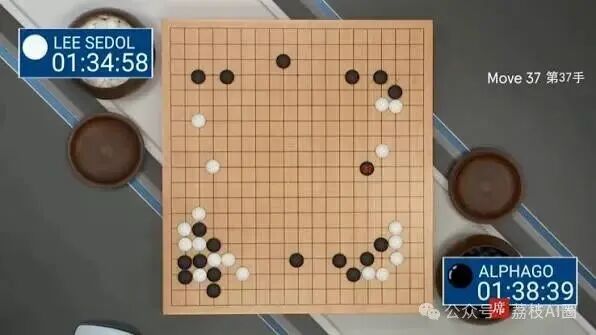
2016 年首尔对局:让人类棋手愣住的「第 37 手」
直播间里的职业九段解说员瞬间愣住了。
在人类几千年的围棋定式里,从来没有人会在布局阶段把棋下在这个位置。最初那几分钟,不少专业棋手甚至怀疑:是不是程序出 Bug 点错了?
当时李世石正好起身离开赛场抽烟。等他回到座位,盯着棋盘上那颗孤零零的黑子,足足思考了十多分钟。
随着棋局往后推演,所有人后背发凉地发现——那颗被误以为是「昏招」的第 37 手,早已在几十步之外织好了一张大网,最终帮 AlphaGo 赢下了那一局。
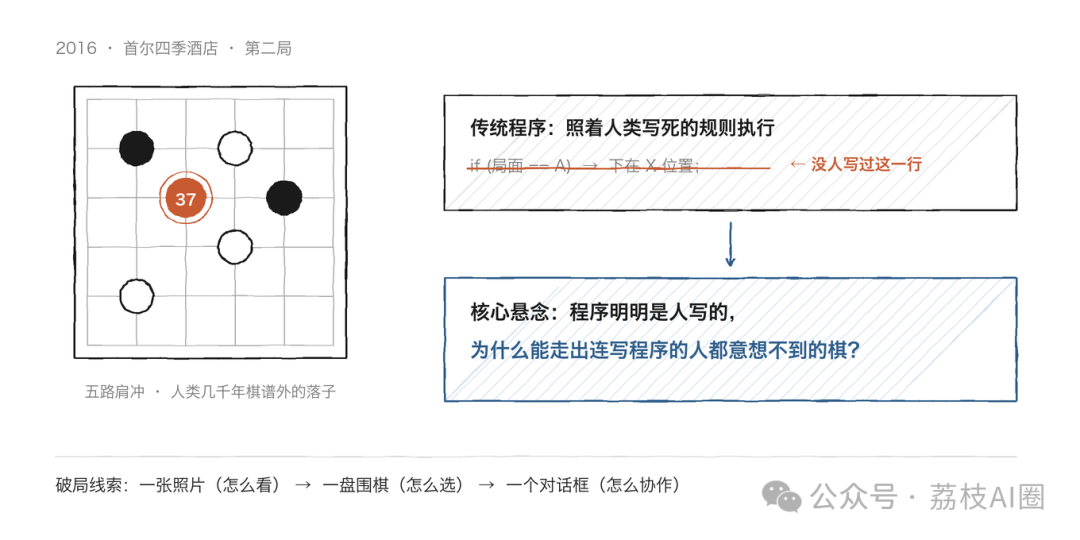
今天回头看,那颗棋子真正让人着迷的地方,不在于「机器赢了人」,而在于一个违背直觉的悬念:
程序明明是人类一行行代码写出来的,为什么它能走出连写程序的人都意想不到的一步棋?
把这颗棋子先留在棋盘上。
我们把时针往回拨,顺着「一张照片、一盘围棋、一个对话框」的脚印,看看过去八十年里,人类是怎么一步步撞上南墙,又靠一篇篇改写历史的论文,把 AI 带到我们办公桌前的。
一、第一堵墙:你能写出「认出一只猫」的所有规则吗?
故事的起点,始于一个今天听起来依然很酷的问题:机器能思考吗?
1950 年 10 月,身在英国曼彻斯特的艾伦·图灵(Alan Turing)在哲学期刊《Mind》上发表了一篇论文。
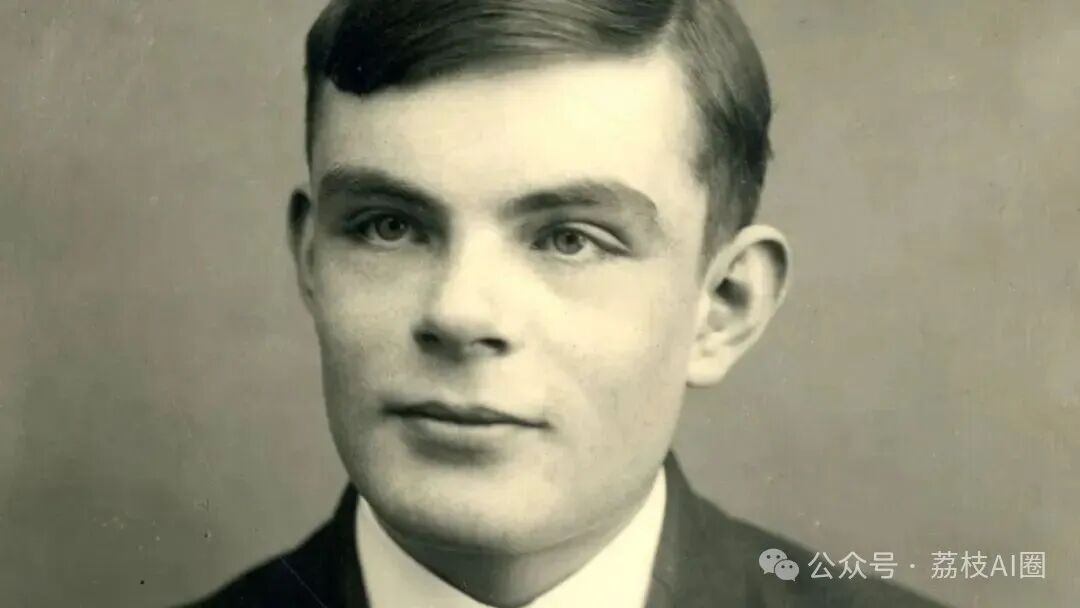
艾伦·图灵(Alan Turing)
他做了一件特别聪明的事——不再跟人空谈「思考」或「意识」的哲学定义,而是设计了一场「模仿游戏」:隔着一道屏障用文字问答,如果裁判分不清对面坐着的是人还是机器,那我们就得承认它表现出了智能。这就是著名的“图灵测试”。
六年后的 1956 年夏天,麦卡锡、明斯基、罗切斯特和香农四位学者,把一群志同道合的研究者召集到美国达特茅斯学院。
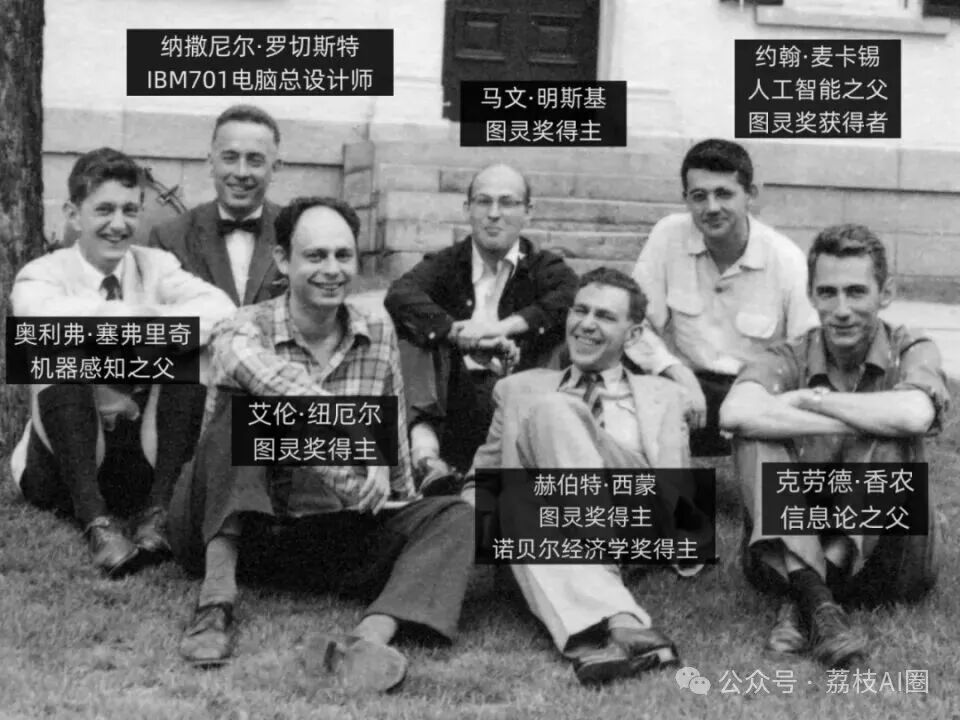
在前一年提交的研究提案里,他们正式写下了 Artificial Intelligence(人工智能) 这个名字。AI这个词第一次出现在人类的视野中。
名字有了,大旗竖起来了,接下来该怎么干?
最符合人类直觉的办法,叫**「写规则」**:把人类的知识拆成一条条「如果……就……」的逻辑,输进电脑里。
这条路在早期走得相当顺。
-
1966 年,麻省理工学院的魏泽鲍姆(Joseph Weizenbaum)写出了对话程序 ELIZA。它其实根本听不懂人话,只是靠抓取句子里的关键词、按语法规则把你的话拆开再反问回去(比如你说「我很难过」,它就回「为什么你会觉得难过?」)。就这么几百行规则,居然让不少人聊得热泪盈眶,觉得机器真懂自己。
-
1980 年,卡内基梅隆大学与 DEC 公司合作的专家系统 R1 走进工厂流水线,靠整理好的规则帮客户自动配置复杂的计算机订单。
-
1997 年 5 月,这条路线迎来了最辉煌的高光时刻——IBM 的 「深蓝(Deep Blue)」 在纽约六局对抗赛中,以 3.5∶2.5 击败了国际象棋世界冠军卡斯帕罗夫。庞大的开局残局库、精妙的局面评估规则,加上每秒搜索上亿步棋的专用芯片,让机器在棋盘上站上了巅峰。
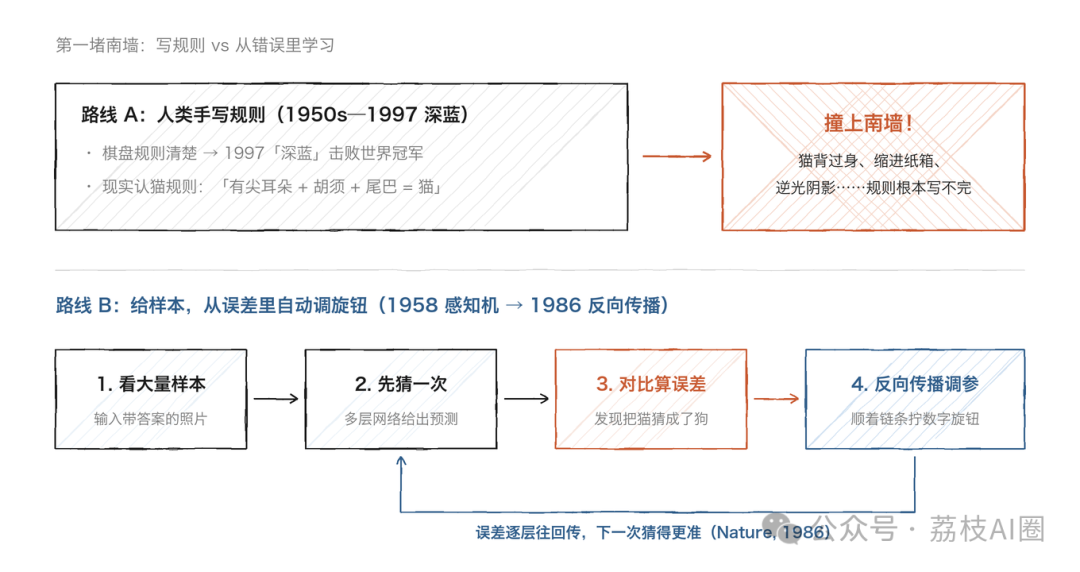
既然连世界冠军都赢了,按这个路子往下写,机器是不是很快就能无所不能?
恰恰相反,研究者们一头撞上了一堵看不见的南墙。
如何教电脑从照片里认出一只猫?
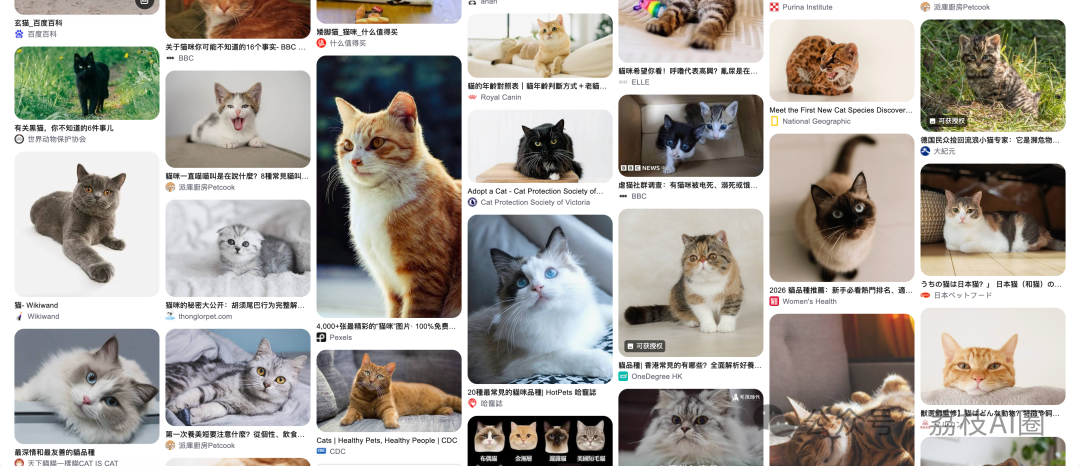
怎么写规则?你写:「有两个尖耳朵、有胡须、有长尾巴、四条腿的,就是猫。」
可狗也有尖耳朵和四条腿;如果这只猫正背对着镜头,胡须看不见怎么办?如果它缩在纸箱里,尾巴和腿全挡住了怎么办?如果是在逆光的深夜拍的,连轮廓都糊成一团呢?
你会绝望地发现:连三岁小孩扫一眼就能认出来的东西,人类哪怕写上一万条规则,也穷举不完现实世界里的光线、角度和遮挡。
现实中太多规则,几乎无法穷举。到了 1970 年代(比如 1973 年英国著名的《Lighthill 评估报告》)和 1980 年代末,科研经费几度大幅缩水,AI 经历了漫长的「寒冬」。
既然人没法把规则一条条写死,能不能换条路——别给机器背规则了,直接给它看照片,让它自己从错误里摸索规律?
跟「写规则」并行的还有一条「机器学习」的暗线,他没有写规则见效快,但是也有人前赴后继努力着:
1943 年《人工神经元》
(麦卡洛克、皮茨):先把大脑里的神经细胞抽象成数学上的「开关」——收到信号达到阈值就亮灯。那时候它还只是死板的积木,不会自己学习。
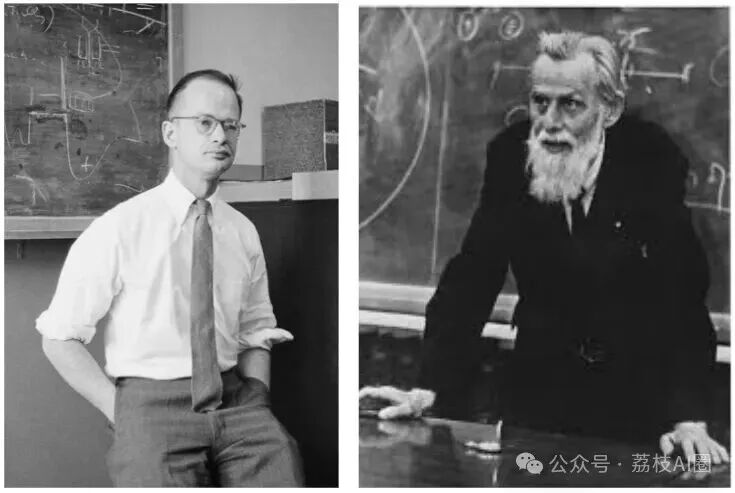
沃尔特·皮茨(左)和沃伦·麦卡洛克(右)
1958 年《感知机(Perceptron)》
(罗森布拉特):开始让机器看带答案的样本。猜对了保持原样,猜错了就把连接处的数字旋钮(权重)拧一点点。可惜单层感知机太简单,1969 年明斯基和帕佩特出了一本专著《Perceptrons》,用数学证明了它在复杂问题上的局限。
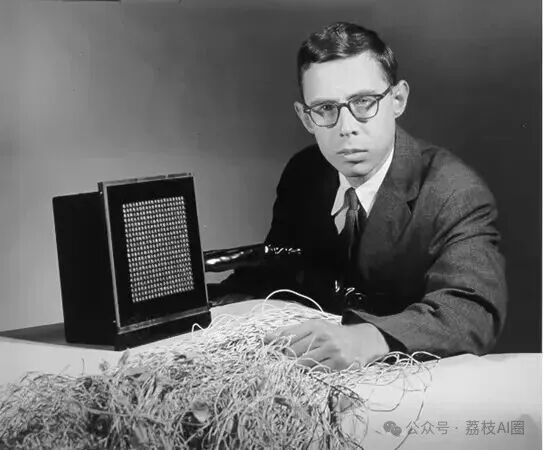
弗兰克·罗森布拉特和他的感知机
1986 年《Nature》经典论文《反向传播(Backpropagation)》
(鲁梅尔哈特、辛顿、威廉姆斯):当网络变成好几层、大家一起把题答错时,怎么知道哪一层的哪个计算该负责?这篇代表作展示了怎么从最终的误差出发,顺着链条一层层往回倒推,算出每层计算是否正确,误差多少,层层优化。
杰弗里·辛顿(Geoffrey Hinton),后面他还会出场
你可以把「反向传播」想象成一条多人协作的流水线:最后生产出的零件不合格,质检员顺着工序倒查回去,精准告诉每一道工序的工人「你手里的刻度往左调一格」。
方法找到了!可为什么到了 1990 年代甚至 2000 年代初,这套方法还是没能掀起滔天巨浪?
因为大家很快撞上了第二堵墙。
二、一张照片的逆袭:在算法爆发前,有人先花几年「编教材」
想象一下,你想教一个从没见过动物的孩子认识「猫」,但你手里只有三张照片,而且拍的都是同一只趴在红沙发上的白猫。
孩子看完可能会得出一个结论:凡是白色的、毛茸茸的、底下垫着红布的,就叫猫。明天带他出门遇到一只蹲在树枝上的黑猫,他就彻底懵了。
光有聪明的学习方法不够,机器还得见过足够多、足够杂的真实世界。
在很长一段时间里,学界绝大多数人都在绞尽脑汁改算法、调模型,觉得整理数据是件不够高级的「苦力活」。
直到 2000 年代中后期,当时在普林斯顿大学任教(2009 年加入斯坦福大学)的李飞飞,和邓嘉等合作者做了一个大胆的决定:既然机器缺教材,那我们就把整个互联网的图片整理成一套庞大的「世界教材」。
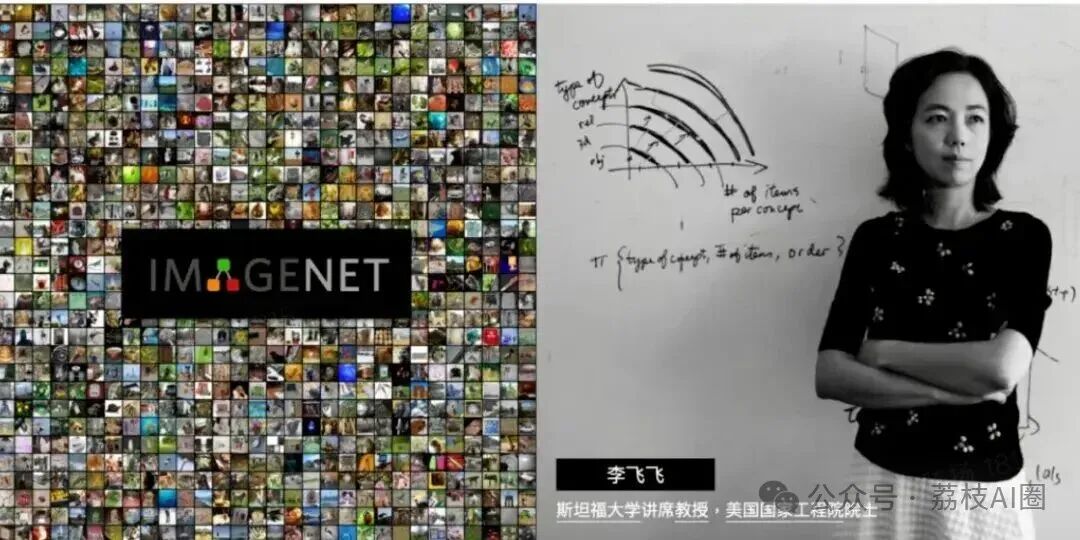
李飞飞
2009 年,团队在 CVPR 上发表了《ImageNet》数据集论文。
他们从网上收集了海量的图片,发动全球各地的标注者一张张人工核对、分类。仅在 2009 年论文发布时的版本里,就已经整理出了 5,247 个类别、大约 320 万张清晰标注的照片。同一种动物,不管是在雪地里跑、水里游、只露半张脸还是躲在阴影里,机器都能在 ImageNet 里见到。
不仅如此,他们还设立了每年一度的「ImageNet 图像识别大赛(ILSVRC)」。ImageNet 既当了机器的「教材」,又搭起了全球算法的统一「考场」。
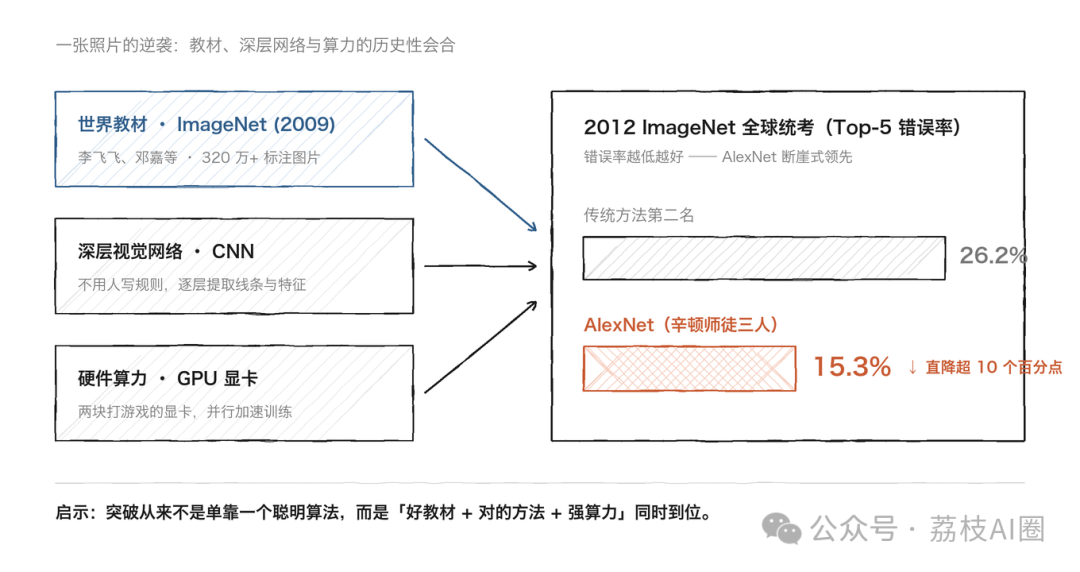
教材和考场准备好了,真正的惊雷在 2012 年 炸响。
那一年,加拿大多伦多大学的杰弗里·辛顿(Geoffrey Hinton)带着两名学生——亚历克斯·克里热夫斯基(Alex Krizhevsky)和伊利亚·苏茨克维(Ilya Sutskever),交出了一篇后来被称为 《AlexNet》 的论文。
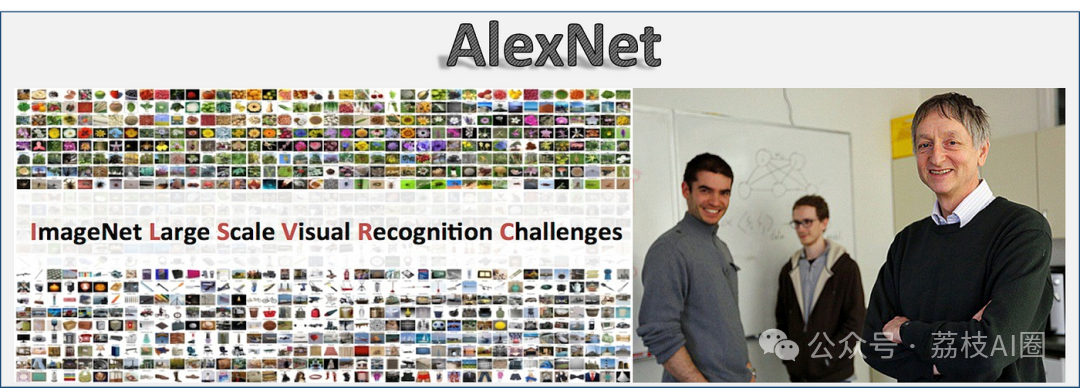
在那场全球统考里,第二名的前五项识别错误率(Top-5 Error)是 26.2%,而 AlexNet 一举把错误率降到了 15.3%——整整拉开了超过 10 个百分点的断崖式差距!
AlexNet 凭什么能赢这么多?因为它刚好踩中了三股力量的历史性交汇:
-
有教材:ImageNet 提供了足够丰富的练习题;
-
有方法:把早年杨立昆(Yann LeCun)在 1998 年
LeNet-5手写支票识别里验证过的卷积神经网络做深,不用人手写「猫耳朵长啥样」,网络第一层自己学边缘线条、中间层拼出眼睛耳朵、最后一层认出整只猫; -
有算力:克里热夫斯基用上了两块原本用来渲染 3D 游戏的 NVIDIA GPU 显卡,让原本要算几个月的深层网络,几天就能训练完。
三年后的 2015 年,何恺明等人又提出了 《ResNet(残差网络)》——给网络加上一条「跳级捷径」,让模型只学「在原来的基础上改一点点」,彻底解决了网络层数太深反而学不好的难题,把图像识别推到了超越人类肉眼测试的水平。
「一张照片」的故事告诉我们:AI 的爆发从来不是某个天才算法单枪匹马的奇迹,而是「好数据 + 对的结构 + 强算力」三根绳子终于拧在了一起。
三、一盘围棋的两面:第 37 手看见突破,第 78 手看见边界
机器学会了「看懂照片」,可现实生活不只有看图分类,还有连续不断的博弈和决策。
于是在 2016 年春天,我们回到了文章开头首尔的那张棋盘前。
国际象棋早在 1997 年就被「深蓝」攻克了,为什么围棋又让科学家熬了将近二十年?因为围棋盘上有 361 个交叉点,变化比宇宙里的原子总数还要多。靠「深蓝」那种把后面每一步都穷举算出来的硬办法,哪怕把全球电脑绑在一起也算不完。
那 AlphaGo 是怎么长出那记惊世骇俗的「第 37 手」的?
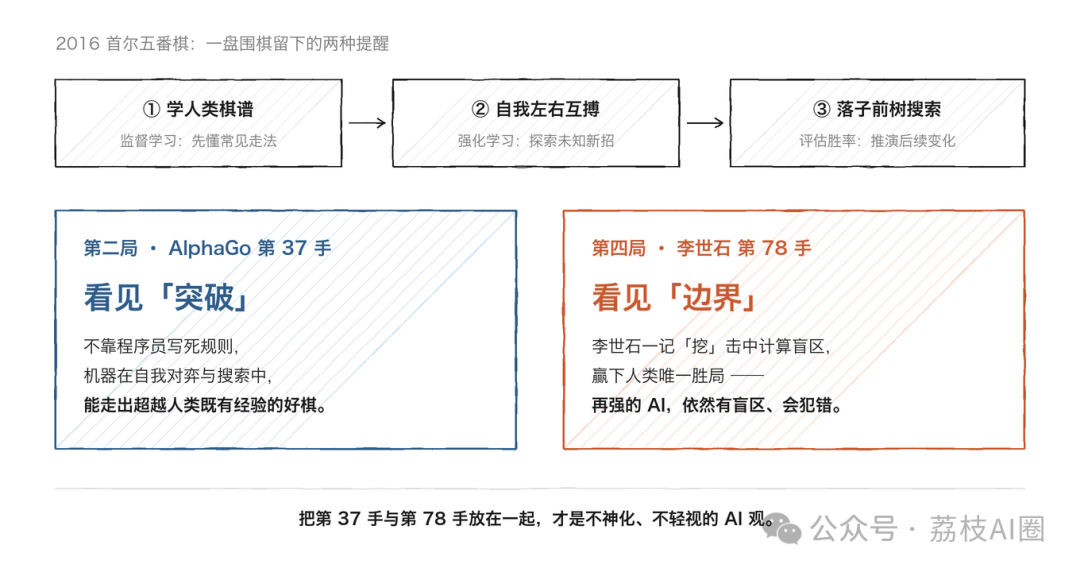
翻开 DeepMind 团队在 2016 年 1 月发表于《Nature》的 AlphaGo 方法论文(当时报告了此前 5∶0 击败欧洲冠军樊麾的实验),你会看到一套极其漂亮的组合拳:
-
先拜师学艺(监督学习):先让神经网络读几千万局人类高手的棋谱,学会「看到这个局面,人类高手大概会考虑哪几个点」;
-
再左右互搏(强化学习):让两个 AI 自己跟自己下上百万盘棋。赢了就加分,输了就调整——在这无数盘人类从未下过的对局里,它摸索出了超越人类既有经验的走法;
-
落子前深思(蒙特卡洛树搜索):真正比赛落子前,它不是拍脑袋随便下,而是用「策略网络」挑出几个有戏的落点,用「价值网络」估算局面胜率,再往后推演模拟几万种可能。
所以,首尔第二局的第 37 手,既不是程序员提前写死的,也不是从哪本古谱里抄来的——它是学习、反复试错的反馈与树搜索配合出来的产物。
到了 2017 年 10 月,DeepMind 发布的 《AlphaGo Zero》 更进一步:干脆连人类棋谱都不看了,只告诉它围棋规则,让它从零开始随机乱下、自我对弈。只要规则清楚、胜负反馈明确,机器自己就能给自己创造高质量的练习题。
故事讲到这儿,如果只停在「AlphaGo 4∶1 大胜李世石」,那就只讲了一半。
在第一课的史料里,有一处最值得所有用 AI 的人记住的细节:第四局的「第 78 手」。
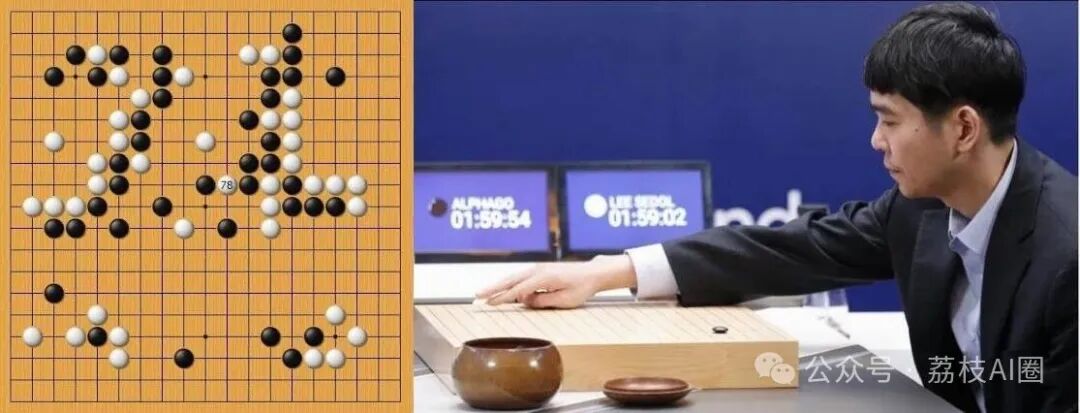
第四局的「第 78 手」
那是 2016 年 3 月 13 日,已经连输三局、背水一战的李世石,在中腹下出了极为犀利的「挖」——第 78 手。这一手棋直接把局面拖入了极其复杂、罕见的死活计算中,精准戳进了 AlphaGo 当时价值评估与搜索的盲区。随后几步,AlphaGo 连续出现反常的昏招,最终投子认输。
这也是人类顶尖棋手在正式比赛里赢下 AlphaGo 的唯一一局。
把这两步棋摆在一起,才是完整的 AI 启示录:
第二局的第 37 手,让我们看见机器能够突破人类经验的上限;
第四局的第 78 手,则时刻提醒我们——再强大的系统,依然有它的盲区,依然可能犯错。
四、一个对话框的诞生:机器是怎么「听懂」人话的?
能认照片、能下围棋,离我们普通人的日常工作好像还隔着一层纱。毕竟我们每天上班,不是在标图片,也不是在下围棋,而是在说话、写字、看文档。
可教机器处理人类语言,比教它认猫难在另一个维度上:语言的意思,全藏在潜台词里。
请看下面这句话:
「记者采访了馆长,他详细介绍了图书馆的新安排。」
不用一秒钟,你就知道句子里的「他」指的是馆长,而不是记者。可如果把后半句改成「他连夜赶回了报社写稿」,「他」就立刻变成了记者。
早期的循环神经网络(包括 1997 年提出、给网络加上记忆笔记本的 《LSTM》),读文章像一个人拿着放大镜逐字往后挪:读完第一个字,传给第二个字,再传给第三个字……句子一旦拉长到几百上千字,开头说的重点传到句尾早就模糊了,而且必须一个字等前一个字算完,没法让几千块 GPU 同时开工。
怎么破局?2017 年 6 月,一篇改写整个现代 AI 走向的论文挂上了 arXiv。
论文的名字霸气十足,叫 《Attention Is All You Need(注意力就是你所需要的一切)》,由 Google 团队的 Vaswani 等八位作者共同署名,提出了今天无人不知的 Transformer 架构。
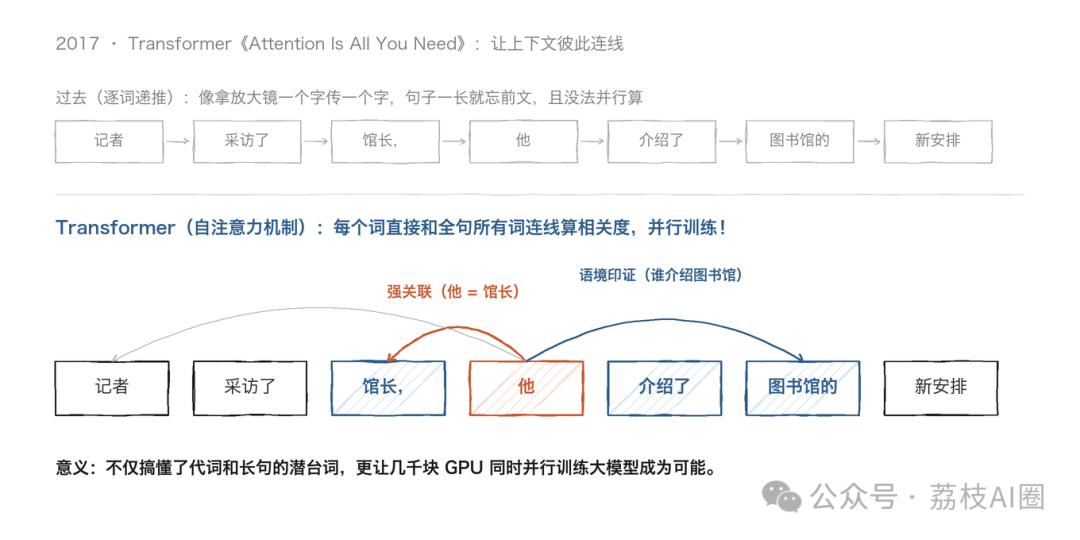
Transformer 的核心直觉:用「注意力」让句子里的词直接跨距连线
Transformer 干了一件极其干脆的事:扔掉一个字传一个字的慢办法,直接用**「自注意力机制(Self-Attention)」**,让句子里的每一个词,同时和前后文所有的词拉起连线、计算相关度。
当模型读到「他介绍了图书馆的新安排」里的「他」时,注意力机制会直接跨过中间的词,在「他」「馆长」「图书馆」之间亮起高权重的连线。更关键的是,这种结构不需要排队等前一个词算完,天生适合用大规模算力并行训练!
地基打好了,大楼开始以惊人的速度往上盖:
-
2018 年:Google 的 《BERT》 像做完形填空一样,靠左右双向上下文刷新了语言理解纪录;而 OpenAI 的 《GPT-1》 选择了另一条路——只做一件事:根据前面的字,预测下一个字是什么(生成式预训练)。
-
2020 年 1 月与 5 月:OpenAI 先后发了 《Scaling Laws(规模定律)》 和 《GPT-3》 论文。当模型参数被推到惊人的 1,750 亿、读遍了半个互联网的文本后,神奇的事情发生了——你不需要再为了翻译、写摘要或改病句去重新训练它,只需要在提示词里给它看两三个例子(Few-Shot 少样本提示),它就能顺着你的意思把活干出来!
但这时候的 GPT-3 还像一个满腹经纶却不懂职场规矩的怪才:你问它「怎么写周报?」,它可能会以为你在出考卷,顺手给你接着往下续写十个问题:「怎么写月报?怎么写年终总结?」因为它只学会了「接着往下编」,没学会「按人的指令办事」。
于是,最后一块拼图在 2022 年 补齐了:
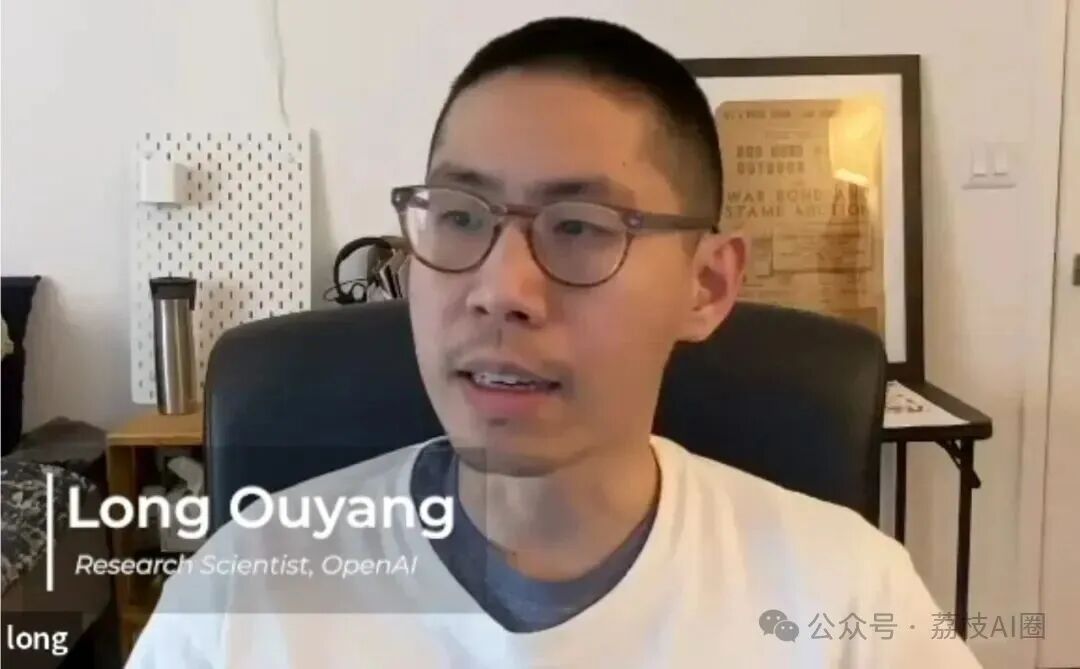
2022 年 3 月,《InstructGPT》论文(欧阳龙等)展示了怎么给大模型「立规矩」:先让人写好标准示范教它怎么接话,再让人对模型的几个回答排出好坏名次,训练一个打分器,用强化学习(PPO)引导模型说出更贴合人类要求的话。
2022 年 11 月 30 日,OpenAI 把这套经过指令微调和反馈训练的模型,装进了一个人人都能上手的网页对话框里——ChatGPT 研究预览版正式上线。
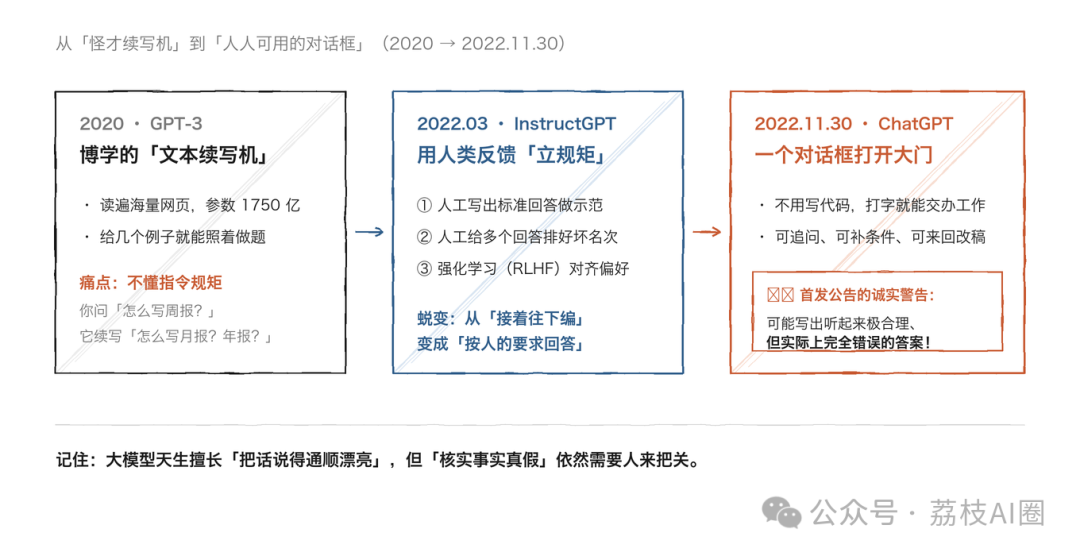
过去需要写代码调接口的 AI 能力,突然变成了一个只要会打字就能使唤的对话框。普通人第一次发现:原来我可以把几千字的会议记录扔进去让它提炼重点,可以让它帮我改邮件,可以跟它来回对话打磨方案。
但很多人没留意的是,就在 2022 年 11 月 30 日那篇《Introducing ChatGPT》的首发公告里,OpenAI 自己就写下了一条极其诚实的警告:
ChatGPT 有时会写出听起来非常合理、但实际上错误或荒谬的答案。
为什么?因为从根儿上说,它是靠预测「怎么接话最通顺、最讨人类喜欢」训练出来的。把话说得滴水不漏,和把事实核对得准确无误,完全是两码事。
五、从「陪你聊天」到「替你干活」:补齐最后三块短板
既然光靠一个聊天框,AI 会「记忆过时、一本正经胡说八道」,也没法替我们操作外部软件、解开超复杂的逻辑题,最近这几年,研究者们又在忙活什么?
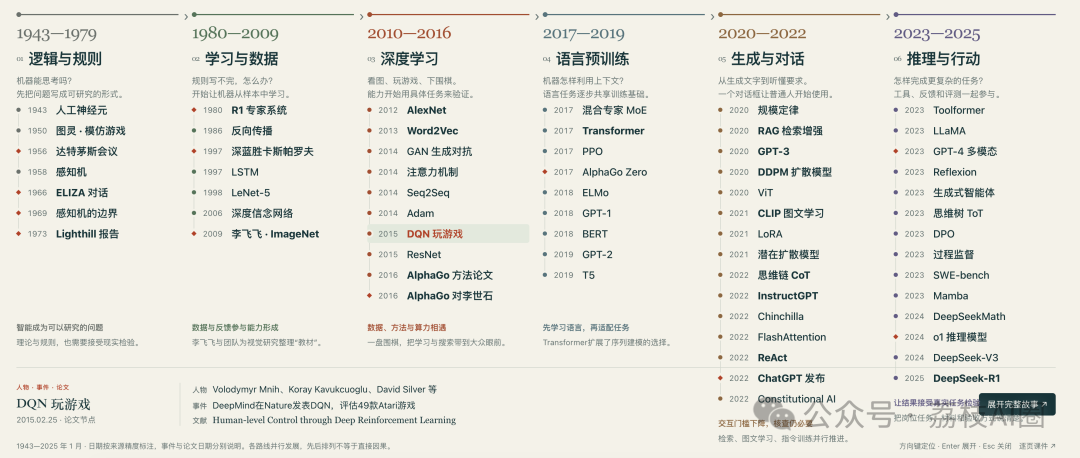
整理的比较核心的论文列表时间线
如果从这 50 篇核心论文里挑出与我们今天工作最息息相关的三条进化线,你会发现它们全是在给大模型「补短板」:
1. 怕它乱编或不懂公司内部事?——让它「先翻书再回答」(RAG)
如果你让一个刚入职的新同事回答公司的报销制度,你肯定不会让他凭空瞎猜,而是先把《员工手册》递给他。
早在 2020 年 5 月,Lewis 等人就发表了 《RAG(检索增强生成)》 论文:提问时,先让检索系统去外部资料库里把相关的原文段落找出来,贴进对话框里,再让大模型看着资料组织答案。今天几乎所有企业的「AI 知识库」和「AI 搜索」,底层都是这个逻辑。
2. 怕它只会动嘴不会动手?——让它「边想边调工具」(ReAct)
真实的工作从来不是「问一句、答一句」就完事了。比如让你核对一份通知并改稿,你得先去查原文件、对比前后版本差异、算一下数字对不对,再动笔改。\
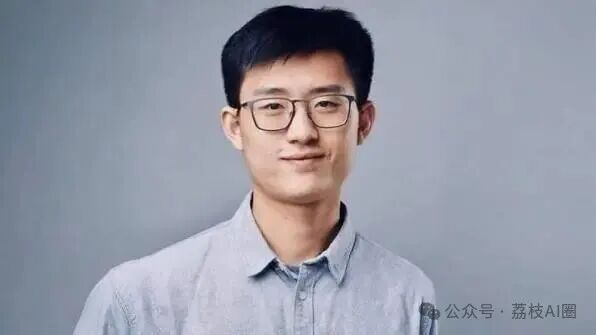
姚顺雨
2022 年 10 月,姚顺雨等人提出的 《ReAct(Reasoning + Acting)》 论文,把大模型的思考过程和调用外部工具(查网页、跑代码、读表格)串成了一个循环:先想下一步干嘛 → 动手调工具 → 观察工具返回的结果 → 再决定下一步。这就是今天大火的 AI Agent(智能体) 的核心工作流。
3. 遇到难题总跳步算错?——让它「打草稿慢思考」(CoT → o1 → DeepSeek-R1)
以前问大模型一道绕弯子的数学题,如果让它立刻给答案,很容易翻车。
- 2022 年 1 月,Jason Wei 等人提出 《思维链(Chain-of-Thought)》:只要在例子里把中间解题步骤写出来,模型准确率就会大幅上升。
- 到了 2024 年 9 月的 OpenAI
o1和 2025 年 1 月的《DeepSeek-R1》论文,研究者们把「强化学习」重新搬上了舞台中央。
DeepSeek-R1 证明了一件事:只要给模型足够明确的对错反馈(比如数学题算没算对、代码能不能跑通),让它在强化学习中反复尝试,再配合冷启动数据和多阶段训练,模型就会在回答前投入更多计算,像人类做难题一样在草稿纸上自我检查、推翻重来。
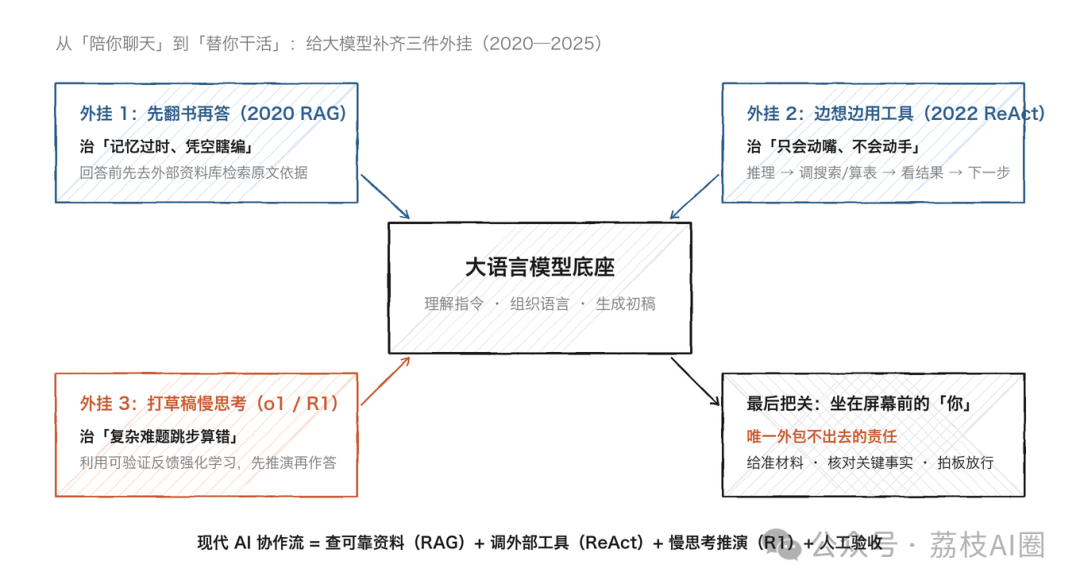
不过,哪怕到了 o1 和 DeepSeek-R1,第一课的历史核验依然送了我们一句清醒的结语:「多想一会儿,并不自动保证结果正确。」 如果喂给它的前提材料本身是错的,或者任务根本没有客观的对错标准,写得再长的思考过程,也需要人来把最后一道关。
写在最后:80 年 AI 史,其实是给普通人的「使用说明书」
我们用几千字走完了从 1943 年到今天的八十年。
现在回头看,AI 走到我们身边,从来不是因为某一天机器突然「觉醒」了灵魂,而是几代研究者像接力一样,一次次改写问题、补齐拼图。
你会发现一个特别奇妙的呼应:当年科学家训练 AI 踩过的所有坑,恰恰就是今天我们在工位上用好 AI 的说明书。
下次当你在电脑前打开那个对话框,准备把一项工作交给 AI 之前,不妨先用这段历史留下的**「三个问题」**问问自己:
-
我给够「教材」了吗?
就像李飞飞为视觉模型准备 ImageNet、就像 RAG 先检索文档一样——别指望 AI 有读心术,把任务背景、原始资料和参考样板先喂给它。 -
我打算怎么找它的「第 78 手」漏洞?
不管它的回答排版多漂亮、推理过程写得多长,永远默认它可能在某个关键数字、人名或引语上「自信地胡说」。定好你的验收清单。 -
哪一步必须由我亲自拍板?
机器可以帮你搜集资料、比对差异、生成三版草稿,但判断哪份材料有效、承担最终交付结果责任的人,永远坐在屏幕前。
一张照片,教会了机器看见世界;
一盘围棋,教会了机器权衡与探索;
一个对话框,把这八十年的智慧推到了每个人手边。
而故事的下一章,不在实验室的论文里,在你每天打开对话框、写入提示词的时刻。
参考资料与核心文献
-
W. S. McCulloch, W. Pitts, A Logical Calculus of the Ideas Immanent in Nervous Activity, 1943
-
A. M. Turing, Computing Machinery and Intelligence, Mind, 1950
-
J. McCarthy, M. L. Minsky, N. Rochester, C. E. Shannon, A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, 1955 / 1956
-
F. Rosenblatt, The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain, 1958
-
J. Weizenbaum, ELIZA—a computer program for the study of natural language communication between man and machine, CACM, 1966
-
D. E. Rumelhart, G. E. Hinton, R. J. Williams, Learning representations by back-propagating errors, Nature, 1986
-
M. Campbell, A. J. Hoane Jr., F.-H. Hsu, Deep Blue, Artificial Intelligence, 2002(对应 1997 年纽约对抗赛)
-
J. Deng, W. Dong, R. Socher, L.-J. Li, K. Li, L. Fei-Fei, ImageNet: A Large-Scale Hierarchical Image Database, CVPR 2009
-
A. Krizhevsky, I. Sutskever, G. E. Hinton, ImageNet Classification with Deep Convolutional Neural Networks (AlexNet), NIPS 2012
-
D. Silver, A. Huang et al., Mastering the game of Go with deep neural networks and tree search (AlphaGo), Nature, 2016
-
A. Vaswani et al., Attention Is All You Need (Transformer), NIPS 2017
-
T. B. Brown et al., Language Models are Few-Shot Learners (GPT-3), NeurIPS 2020
-
P. Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (RAG), NeurIPS 2020
-
L. Ouyang et al., Training language models to follow instructions with human feedback (InstructGPT), 2022;OpenAI, Introducing ChatGPT, 2022.11.30
-
S. Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models, 2022
-
DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, 2025.01