人怎么做,AI Agent就可以怎么做
大家好,我是荔枝。
上一篇文章「 用前朝的剑,斩本朝的官 」,讲的是用传统的软件工程解决现在AI应用的问题,举的都是反面例子。
今天想从一个正面的例子来聊聊,怎么做,能真正发挥AI的能力,做出惊艳的产品。
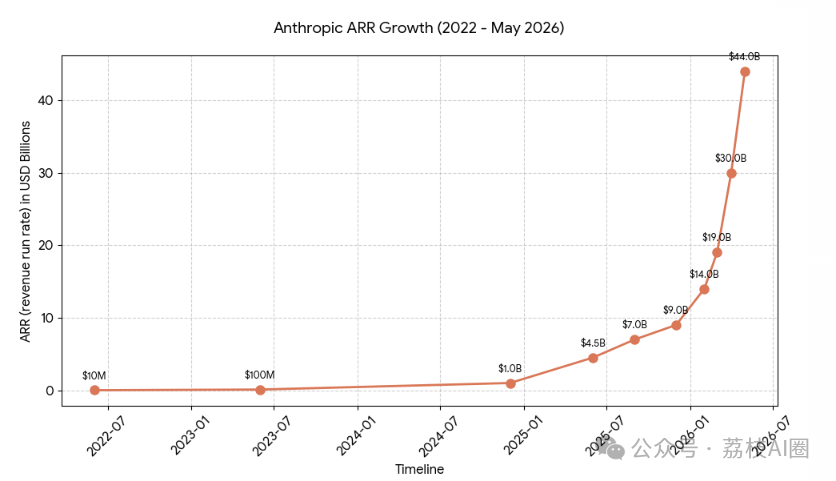
上面这张图是 Anthropic 的收入增长曲线,他们家的核心产品是 Claude Code,一款 AI 写代码的工具。
从去年12月开始,Calude Code 快速增长,一骑绝尘,将写代码这件事儿完全用AI替代了。
之前就有同事问我,如果使用Calude Code来写代码,会不会把我本地的代码都上传呢?
开始我还不确定,仅从token消耗来看,貌似不会全部上传代码,就简单的给了同事结论,“代码不会全部上传”,具体为什么,怎么做到的,我不知道。
这不,前段时间 Calude Code「 被开源 」了,于是终于可以一探究竟,Claude Code 是怎么做到不读所有代码(上传代码),就能写代码的。
人怎么做,AI就可以怎么做
传统方式,需要构建RAG,将代码插入到向量数据库,方便写代码的时候进行查询。
而Claude Code中,没有任何有关于向量,RAG的字眼,取而代之的都是本地检索。
据说Claude Code曾经试图用过向量数据库,将代码向量化,存到向量库中,但是最终放弃了。
为什么呢?
一、代码时刻在变,为了保障Rag的数据一致性,每次变动代码都需要更新数据库,会导致工程复杂度提升。
二、其实我们人类读代码一般都是先查找对应的代码片段(cmd+f),然后看对应的代码逻辑,再看怎么改动。AI足够聪明,可以跟人一样,我们要做的只需要给他提供查找工具,它一样可以先查找代码片段,然后度查找的代码,最后分析怎么改。
三、大模型上下文越来越长,不用像以前需要那么节约,现在可以有更多的内容可以塞,检索的结果,可以全都给到大模型进行甄别和判断。
四、代码中基本都是文本文件,大小可控,而且不涉及到复杂的图片、pdf的检索等等。
这一切天时地利,让传统的Rag方案在Claude Code 中不再实用。
在Claude Code的代码中逻辑很简单。
给大模型了一个代码查找工具,可以通过Bash中的grep命令,快速查找到匹配的结果。
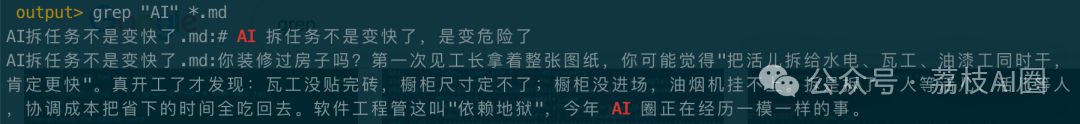
Bash工具对于人类体验不好,但是AI用起来得心应手。
AI检索到所有特定的内容,读前后部分代码,都给到大模型分析,大模型就可以知道代码的逻辑是什么样了,新的需求要怎么来写。
配上高智商的AI大模型,一切如鱼得水。
给AI工具,它的智能远超人类
AI 行业有一个名词叫“自主性”。
如果将 bash 命令行给到 AI Agent ,具体命令行怎么用,是查找文件 grep,还是删除文件 rm,全靠大模型思考和决定,这就叫“自主性”高的 AI Agent。openclaw 🦞就是一个好的例子,它甚至可以自己写脚本,自己用。
如果你将一段业务逻辑封装成一个MCP,比如查询订单中商品件数,确定的逻辑给到AI Agent,就是“自主性”低的 AI Agent,他的确定性更高,但他只能查某个订单中商品件数,更像是一个工具。
哪些场景用哪类Agent,需要有经验AI产品,哪些能做哪些不能做,需要足够的AI Scene。
如果你还是传统软件工程的思维,很难想到还能这么干。
所以我一直都在说,在 AI行业,认知比写好代码重要多了。
有时候写了一周的代码,不如一小时写出来的效果好。
现在AI工程范式还在沉淀中,随着大模型能力的升级,这一切都还在改变。
相关阅读
作者提示: 个人观点,仅供参考