算力的尽头是电力:大模型“吃电”狂飙,中美的底牌究竟在哪?
大家好,我是荔枝。
最近朱啸虎的一个商业访谈里,提到了一个观点,未来中美AI竞争可能会是电力。而电力设施上,中国领先美国。
我承认服务器是很耗电的,机房也需要持续散热降温,但是真的会成为AI竞争的关键因素么?
大模型的训练不都是一次性的么?为什么会持续大量的耗电呢?调用一次大模型到底要用多少电呢?
带着这些疑惑,我决定找下答案。
01. AI到底有多“吃电”?
先看模型训练。
在过去,机房耗电顶多是个散热问题,但在万亿参数时代,它直接变成了重工业。
据估算,训练一个GPT-4级别的模型,耗电量超过50 GWh —— 这笔电量足够整个旧金山连轴转运行整整三天。
下图是公开数据中,大模型的耗电量情况:
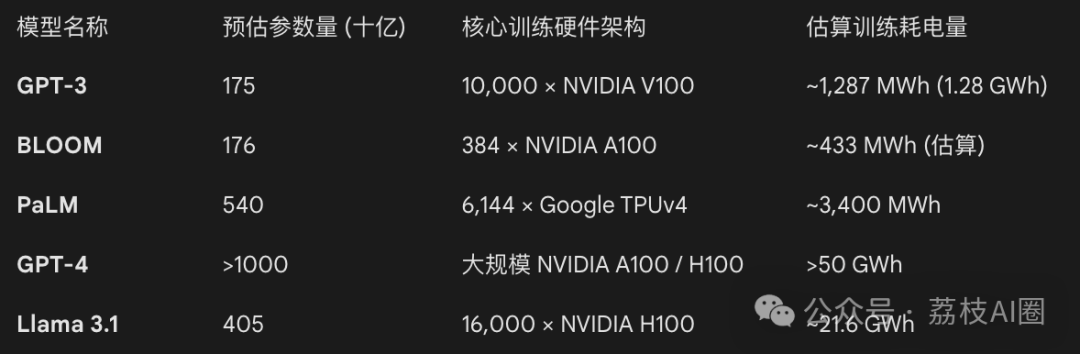
看起来好像也还好吧,但这仅仅是“开胃菜”。
模型训练是一次性的,而“推理”(即用户日常的每一次查询)才是真正的无底洞。
OpenAI首席执行官Sam Altman曾公开表示,ChatGPT平均每次查询消耗约0.34瓦时(Wh)。
0.34瓦时(Wh)能干什么?能支持一个 智能手环/手表 工作电流约 5–10mA 正常用 9~18 小时。
传统的Google搜索单次查询耗电约0.0003 Wh,当我们每次调用ChatGPT,耗电量大约是传统谷歌搜索的千倍以上。
随着AI从处理文本走向生成高清视频,甚至演变为能够自主工作的智能体(Agent),能耗正在呈几何级数爆炸。
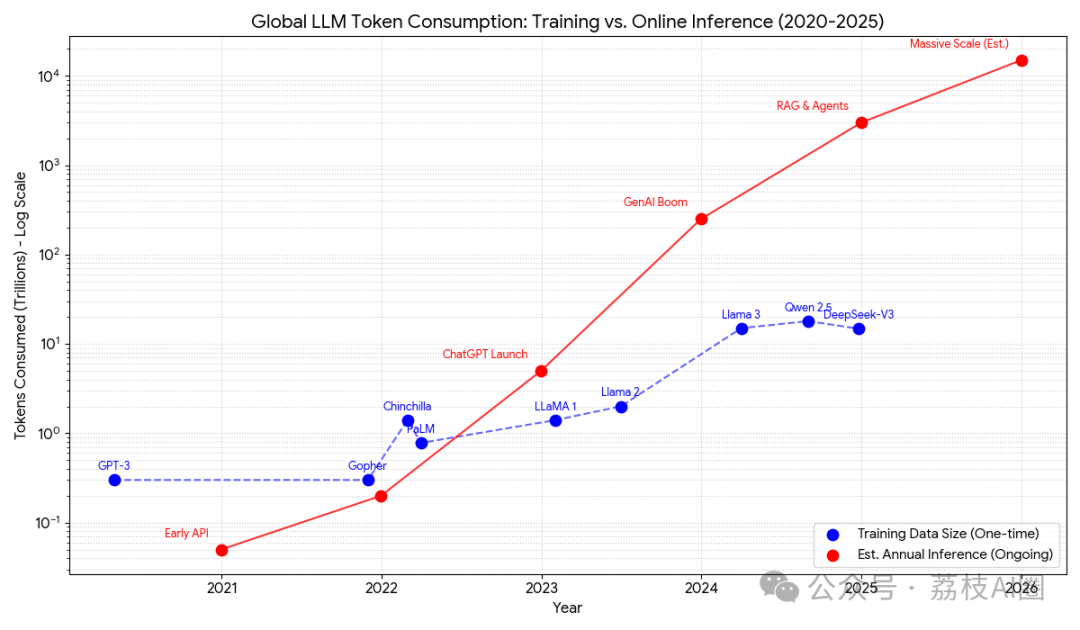
(红色部分为线上调用token数,蓝色为训练消耗token数)
为了应对算力饥渴,芯片的功耗也直线上天。
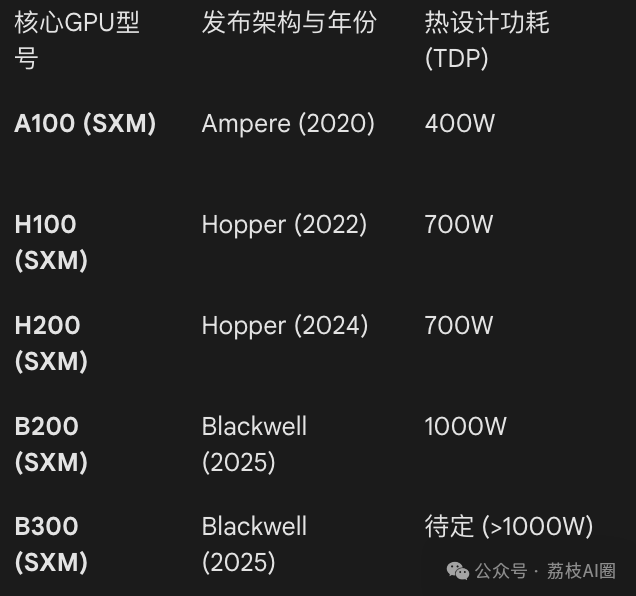
(英伟达历代芯片功耗情况)
英伟达最新的B200芯片,单卡热设计功耗飙升到了惊人的1000W。
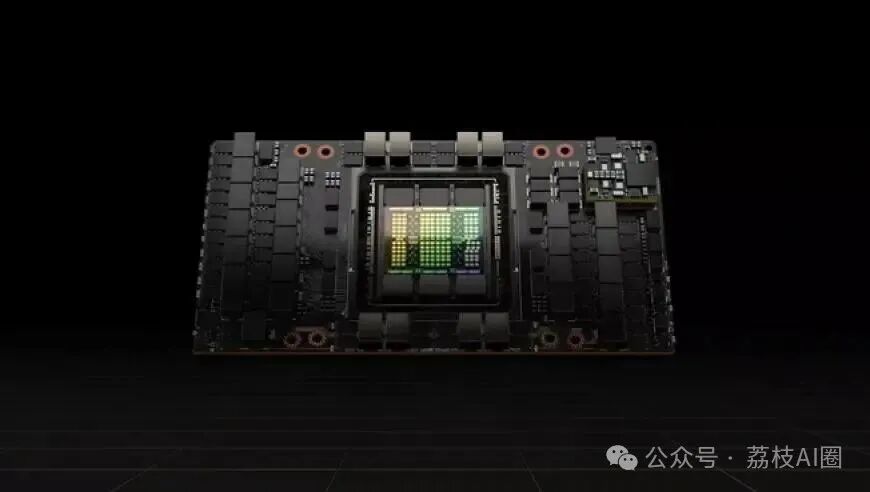
传统的风扇根本压不住这种高温,液冷技术被迫全面上马,而这需要大量的机房改造和新建。
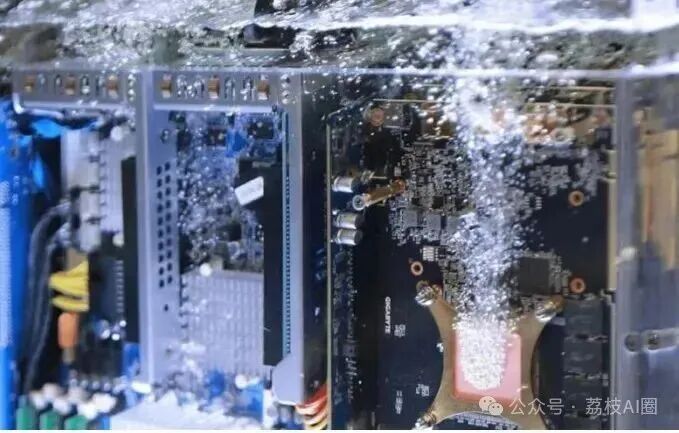
AI,正在硬生生地把自己变成一个超级能源黑洞。
为什么现在使用AI模型,Token还是太贵,速度还是太慢,主要因为太多基建成本,而目前的基建不足以满足所有人进行大模型的调用。
02. 未来五年:电网的“至暗时刻”
权威机构预测,未来几年全球数据中心的用电量将翻一番,飙升至1000 TWh(太瓦时)以上。
这是什么概念?相当于地球上硬生生多出了一个全球排名前十的耗电大国。
更可怕的是瞬间的极端负荷。
预计到2030年,要训练下一代前沿大模型(比如未来的GPT-6),单次任务就需要高达4到16吉瓦(GW)的专属电力支撑。
(红警核电站)
1 GW相当于一座大型商用核反应堆的满负荷输出。
这意味着,未来的科技巨头为了训练一个基座模型,甚至必须自己包下好几座核电站。常规的地方电网,根本承受不住这种瞬间的恐怖吞吐。
03. 中美博弈:从“算力鸿沟”到“电力鸿沟”
在算法和高端芯片上,美国毫无疑问占据先机。但在作为物理底座的电力供应上,局面却发生了戏剧性的反转。
中国有弯道超车的机会。
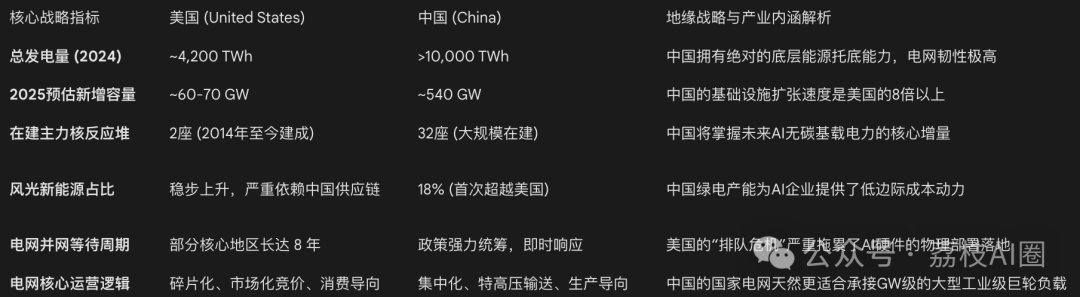
(中美在AI基建上电力部分的对比)
美国的痛点在于基础设施的老化和体制的极度割裂。电网扩容极其缓慢,在全美最大的电网运营商辖区内,新建一个数据中心想要并网,平均得排队等上令人绝望的8年。
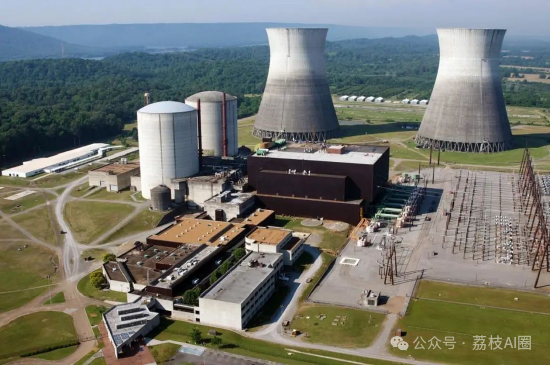
急红了眼的美国科技巨头(如微软、亚马逊)等不及了,只能挥舞着支票“插队”,直接出资重启停用的三哩岛核电站,或者买下核电站周边的土地直接建机房。
此外,由于电网改造缓慢且成本高昂,美国工业用电价格暴涨,这正在严重蚕食AI企业的利润率。
反观中国,能源底盘稳得令人咋舌
2024年,中国的总发电量突破了10,000 TWh,是美国的两倍多。
单单在2025年一年内,中国预估新增的发电装机容量就高达540 GW,是美国的8倍之多。
为了面对未来的能源紧张,中国也正在建的大型核反应堆多达32座,而美国过去十年里只建成了2座。
更关键的是国家级的宏观物理统筹。
中国正在强力推进“东数西算”超级工程,把极度耗电的AI后台训练任务,直接物理搬迁到风光绿电丰沛、气候冷凉的西北内陆(如宁夏、内蒙古)。这不仅就地消化了西部送不出去的新能源,还利用极低的电价和自然冷却环境,将大模型的运行成本降到了极致。
对于中国AI企业来说,被美国卡脖子的或许是顶尖芯片的数量,但电力不仅不是瓶颈,反而是最大的结构性后盾。
04. 谁能笑到最后还是未知数
当大模型的演进逼近物理极限,这场数字竞赛的底牌已经翻开。英伟达的GPU决定了AI能跑多快,但电网的容量决定了AI能跑多远。
美国手握最锋利的算力长矛,而中国则铸就了最坚实的电力盾牌。
在奔向通用人工智能(AGI)的马拉松里,谁能以最低的成本、最稳定的方式输出这股庞大的能量洪流,谁就能真正笑到最后。
相关阅读
作者提示: 个人观点,仅供参考